
專案使用的技術、命名習慣與測試要求,可能在不同流程裡都會用到。但這些規則,真的需要每次都讓 AI 全部讀過嗎?整理時,我先問自己:AI 做到哪一步,才需要知道這件事?
我以前維護 CLAUDE.md 與 AGENTS.md 的作法很簡單粗暴:AI 哪裡做得不符合預期,就往裡面再補一條。專案架構、技術、命名、分層、測試與開發規範全部往裡面塞,最後甚至超過 1000 行。當時總覺得,只要寫得夠完整,AI 下次應該就不容易再犯吧?
可是,AI 不論是在討論需求、準備規格,還是修改 code,都可能讀到這些專案指引。原本只想限制實作方式的要求,也會一起帶進規格流程。同一條規則還可能出現在不同檔案,只改了其中一份,其他地方就留下舊說法。
【Day - 8】介紹過,openspec/config.yaml 的 context 可以提供產生 artifacts 時需要的共同背景,rules 則只加入對應 artifact 的 instructions。特定流程的完整操作步驟,也可以留在各自的 Skill 裡。既然已經有這些方式,我還需要把所有內容都塞進專案指引嗎?
我先逐條看:這是多數工作都需要知道的習慣、產生文件時才需要的要求,還是某個流程的操作步驟?能由工具直接檢查的事情,也不用只靠一句提醒。按照這個方式,內容就分到下面四個位置:
| 內容負責什麼? | 我現在放在哪裡? | 適合放的內容 |
|---|---|---|
| 多數工作都需要知道的共用習慣 | 自己維護的 CLAUDE.md/AGENTS.md |
查資料順序、程式碼取捨、回應方式,以及常用或共用 Skill 的使用時機。 |
| 專案背景、artifact 規則與流程設定 | openspec/config.yaml |
穩定的專案背景、各 artifact 的專屬規則,以及語系、audit 與 Worktree 等選擇。 |
| 只有特定情境才需要的完整做法 | Skills | 操作步驟、停止條件、需要詢問使用者的地方,以及完成後怎麼交接。 |
| 可以客觀重複確認的條件 | CLI、tests 與 validate |
文件格式、artifact 相依關係、測試結果,以及其他能由工具直接判斷的條件。 |
以測試要求為例,我不必把所有相關指示都塞進 CLAUDE.md。這個專案有哪些情境需要安排測試,可以放進 rules.tasks,讓 AI 規劃 tasks 時就把它們列進去;實作時先寫測試、再修改 code 的 TDD 步驟,則由 apply 使用的 Skill 指示交代。最後測試有沒有通過,再實際執行測試確認。這些內容雖然都和測試有關,需要用到的時間卻不同。
把背景與規則移到 openspec/config.yaml 後,還得確認放的位置對不對。例如,「design 要交代資料流與模組邊界」只在寫 design 時需要,應該放進 rules.design。如果又把它寫進 context,其他 artifacts 也會一起收到,design 更會重複讀到兩次:
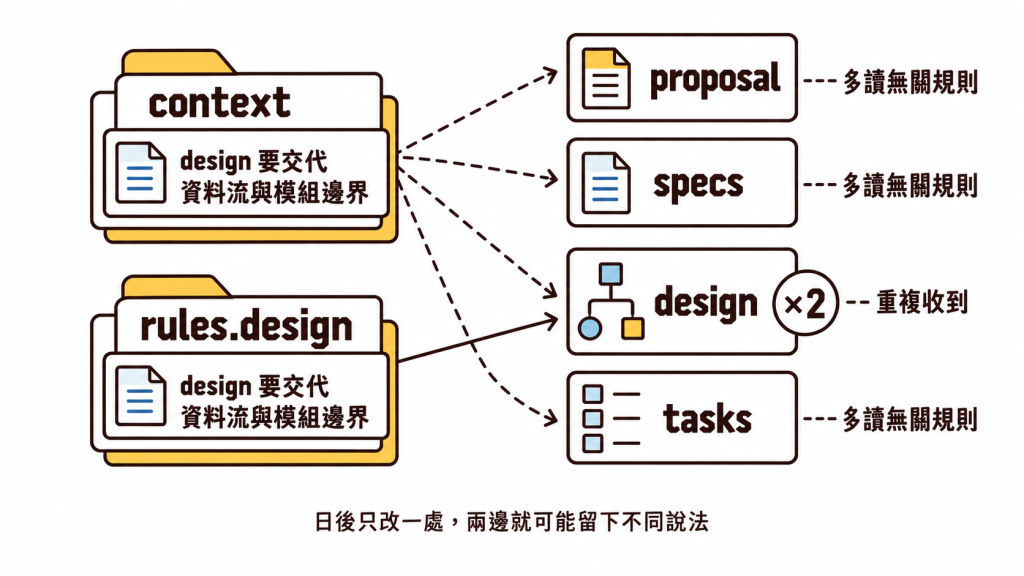
同一條要求放了兩次,之後還得記得一起修改。但 config 不會每天整理,隔幾個月再回來,我還記得當初為什麼這樣放嗎?如果其他人也一起維護,對分類的理解又可能不同,同一條規則就容易被搬來搬去。
所以,我開始設計 Config Skill,希望之後都能按照同一套方式整理。除了怎麼分類,還得先決定它應該讀哪些資料。
一開始和 AI 討論 Config Skill 時,我也想過讓它每次都掃描 codebase,再從目前的程式碼整理出新的 context 與 rules。這個作法看起來最完整,實際上卻很容易把短期實作細節也寫進設定。
context 會跟著每一份 artifact 的 instructions 一起送出。如果裡面記錄某個函式、檔案位置或目前的模組數量,code 一重構,這些內容很快就會過期;下一次整理時,AI 又會依照新的程式碼改寫一次。這樣每次 code 一變,config 也跟著變,反而留不住專案長期穩定的背景。
所以,Config Skill 並不是完全不看 codebase,而是不逐一讀取程式碼檔案。我最後讓它從這五類來源整理:
| 固定來源 | 主要從中找什麼? |
|---|---|
專案根目錄與各套件的設定檔(例如 Cargo.toml、package.json) |
專案有哪些組成部分,以及彼此的技術邊界。 |
| README | 專案用途與使用者。 |
| docs 的入口與索引 | architecture、status 等長期文件的標題與簡述。 |
現有的 openspec/config.yaml |
已經確認過的內容,作為下一次整理的起點。 |
LANGUAGE.md(有準備時) |
專案共用的詞彙。 |
這些來源比較接近「專案怎麼描述自己」,不會因為某個函式換了位置就馬上失效。
來源也要維護: 如果 README 或原本的 config 已經過期,AI 仍可能沿用錯誤內容。限制讀取範圍,是為了少帶入短期實作細節,不代表整理結果一定正確。
只限制從哪裡找還不夠。同一份資料交給不同的人或不同的 AI,仍然可能得到不同分類。因此,Config Skill 還會用四個基準逐條檢查準備寫進設定的內容:
| 檢查基準 | 怎麼處理? |
|---|---|
| 避免重複 | 引擎、schema 或品質檢查 Skill 已經會加入的 instructions,不再寫進 context 或 rules。 |
| 放進正確範圍 | 只對一份 artifact 有效的內容,放進對應的 rules,不塞進 context。 |
| 不記錄很快就會改變的資訊 | 版本、數量、日期與比例等資訊不寫。 |
| 確認引用存在 | 規則提到的檔案、commands 與 tests,現在都必須找得到。 |
四項檢查裡,第一項不能只靠印象判斷。Config Skill 會實際讀取每一份 artifact 的 instructions,確認引擎已經加入哪些內容;如果某項規範已經由其他 Skill 負責,也不會在 config 裡再維護一份。
不過,有些選擇不是讀完專案資料就能決定的。規格要使用哪種語言,以及 tasks 要跑完整測試還是只驗證受影響的範圍,都不能由 AI 看著專案結構自己猜。Config Skill 會把這些選擇逐項問清楚,再透過 speclink workflow-config ... --dry-run 預覽修改前後的差異;等我確認後才寫入。
如果來源資料與使用者的選擇都沒變,再整理一次時,應該沒有需要修改的差異。如果同一句內容每次都被搬來搬去,就表示分類標準還不夠穩定,需要先把原因找出來。
把前面的五類來源和四項檢查放在一起,就是 Config Skill 整理設定的順序:先決定讀哪些來源,檢查內容放得對不對,再問清楚需要我決定的選項,最後預覽修改差異,等我確認後才寫入。
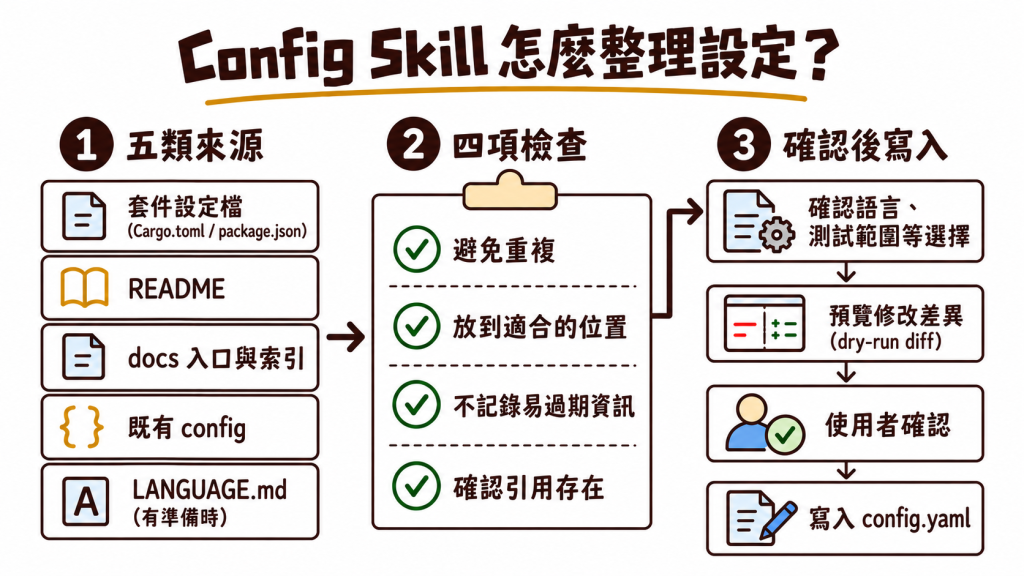
我實際用 Speclink 專案跑過一次 Config Skill 後,原本混在 context 裡的內容也被逐項拆開:引擎已經提供的 instructions 拿掉,只對特定 artifact 有效的要求移到對應的 rules,容易過期的數量與路徑則不再保留。
我原本的 context 有 40 行、2787 個字元,整理後縮成 32 行、1869 個字元。光是 context 的字元數,就少了大約三分之一。這段內容會跟著每一份 artifact 的 instructions 一起送出,少帶一點重複內容,應該也能省下一些 token(不過,這次沒有另外量測 token 數XD)。
不過,這次整理只處理了 artifacts 的背景與規則。Speclink 第一版其實還會把另一段 instructions 寫進根目錄,也就是整套 workflow 的導覽。
【Day - 11】介紹過,當時 Spectra 會在根目錄的 CLAUDE.md 或 AGENTS.md 寫入 marker block,讓 AI 在一般對話中也有機會主動提醒我進入 discuss 或 propose。Speclink 第一版也沿用了這個作法,把 discuss、propose、apply、ingest 與 archive 的使用時機和順序集中放在專案指引裡。
我很喜歡這種 AI 好像知道整條路該怎麼走的感覺。不過,替專案指引瘦身時,我也考量到各個 Skill 的 description 已經交代適合的使用情境,完整內容也包含操作步驟、停止條件與下一步建議。流程改了,根目錄的導覽還得跟著改一次,所以我最後選擇和 OpenSpec 類似的安排,拿掉這段導覽,讓這些指示留在各自的 Skill 裡。
如果我已經指定要使用哪個 Skill,AI 就照著那份指示開始做,不需要再靠專案指引裡的 workflow 導覽。沒有指定時,則要看 Agent 是否會提供 Skill description,讓 AI 判斷哪個流程適合目前的需求;這部分會因執行環境而異,【Day - 11】已經說明過。選好 Skill 以後,具體步驟與完成後的提示,都已經寫在各自的 Skill 裡。
workflow 該放在哪裡確定後,我終於可以回到自己的 CLAUDE.md 與 AGENTS.md:拿掉這些內容後,最後還留下了什麼?
經過這一連串整理後,我現在不再追求把 CLAUDE.md 或 AGENTS.md 寫成專案百科,而是只留下多數工作都會用到,又很難由工具直接判斷的習慣。拿掉專案細節後,大概是這樣。這是我自己的合作習慣,不代表每個專案都要採用相同規則:
# 工作指引

## 專案慣例

- **Commit 用 `conventional-commit` 技能**:description 與 body 寫繁體中文。例:`feat(auth): 新增 GitHub OAuth 登入`、`fix(collab): 修正 Y.js 同步衝突`。
- **查資料順序**:專案內既有規格與程式碼(搭配對應 Skills)→ `context7` 等已接的 MCP → 最後才網路搜尋。不要憑印象猜 API 簽名。

## 程式碼取捨

- 不為一次性使用的程式碼建立抽象層;不加沒被要求的「彈性」或「可設定性」。
- 錯誤處理只在系統邊界驗證(使用者輸入、外部 API),內部程式碼當成可信;不為不可能發生的情境寫防護。
- 寫了 200 行但 50 行能搞定就重寫。判準:資深工程師會不會覺得這太複雜?
- 清掉因為這次修改而不再使用的 imports/變數/函式;原本就沒用到的程式碼先提醒我,不要順手刪除。
- 有更簡單的做法直接說出來,並講清楚你的假設。
這裡的 conventional-commit 是我另外使用的 Skill,所以專案指引只保留「什麼時候用它」與我在意的語言,完整流程仍然回到 Skill。其餘內容多半是查資料與寫 code 時的取捨,沒辦法穩定交給 test 或 validate 判斷,才值得在不同工作階段都提醒 AI。
不過,這也不是整理一次就固定下來的版本。模型的行為會變,我和 AI 的協作方式也會跟著調整。以前為了避免某個問題加上的提醒,換了模型後可能已經不需要,甚至會讓它過度遵循原本只想稍微限制的做法。所以,這些指引除了新增,也需要定期回頭檢查哪些該改、哪些可以拿掉。
換模型時也要回頭看: Claude Fable 5.1 的指引就提醒,舊提示裡壓制進度回報的要求,可能需要移除。規則要不要留下,還是得看目前的需求與模型表現,不能只看提示詞長短。
整理到這裡時,我也剛好看到 Matt Pocock 訪談 Uncle Bob 的影片。Uncle Bob 說,他一開始也會把 Clean Code 和自己對 code 的要求全部寫進 prompt,結果愈寫愈長,最後變成五到十頁。後來,他反而只留下最少、最必要的內容。
看到這段時,我馬上想到自己原本那份長得誇張的 CLAUDE.md。雖然我們使用的工具和內容不完全相同,但都曾經想把要求寫得愈完整愈好,深怕少交代一句,AI 就會做錯。整理過後,我反而比較清楚哪些需要一直提醒,哪些等做到那一步再說就好。
至少現在,AI 準備寫規格時,需要參考哪些背景、遵守哪些要求,都有地方可以找了。但回頭看專案,還有另一個問題:新功能可以透過 change 慢慢補上規格,那些早就寫好、一直在運作的功能呢?
如果也想把這些既有功能整理成正式 specs,該從哪裡開始,又要怎麼確認 AI 寫的和程式實際做的一樣?接下來,就來聊聊這個問題吧!
config.yaml


 iThome鐵人賽
 看影片追技術